
3줄 요약
- 클로드 드리밍은 모델을 재우는 기능이 아니에요. AI 에이전트가 쉬는 동안 지난 작업 기록을 다시 읽어서, 적어 둔 메모 가운데 틀린 건 고치고 겹친 건 합치는 기능이에요.
- 앤트로픽 실험에서 드리밍으로 메모를 고친 클로드는 포켓몬 게임에서 못 넘던 산을 넘었어요. 드리밍을 128번 돌려 만든 위키만 보고 질문에 답하게 했더니 점수가 13%에서 48%까지 올랐고요.
- 드리밍은 지금 개발자용 Claude Managed Agents에서 신청해야 쓸 수 있는 연구 미리보기예요. 클로드 앱이나 클로드 코드에는 아직 공식 드리밍 기능이 없어요.
"AI가 꿈을 꾼다." 요 며칠 AI 소식을 봤다면 이 문장을 한 번쯤 지나쳤을 거예요. 11월 6일 앤트로픽이 엔지니어링 블로그에 에이전트 기억을 다룬 긴 글을 올렸는데, 그 한가운데에 드리밍(dreaming)이라는 말이 들어 있었거든요.
이름만 들으면 이런저런 상상부터 하게 돼요. 밤마다 서버를 꺼 두나, 모델이 혼자 엉뚱한 걸 지어내나. 실제로는 사람 뇌에서 따온 이름이에요. 사람은 낮에 겪은 일을 곧바로 기록하지만, 그걸 오래가는 지식으로 다지는 일은 상당 부분 자거나 멍하니 쉬는 동안 일어난다고 해요. 앤트로픽은 글 첫머리에 이 설명을 두고, 에이전트도 일을 이렇게 나눌 수 있다고 썼어요.
그런데 앤트로픽이 이 얘기를 하면서 꺼낸 예시가 뜻밖이에요. 포켓몬이었거든요. 🎮
클로드가 포켓몬 게임을 하다 메모 하나를 잘못 적었고, 그 메모 때문에 같은 함정에 세 번이나 빠졌어요.
😴 클로드 드리밍은 모델을 재우는 게 아니에요
드리밍은 클로드가 쉬는 틈에 자기 메모장을 다시 손보는 일이에요.요즘 AI 에이전트는 대화 한 번으로 끝나지 않아요. 같은 일을 며칠씩 이어서 하다 보니, 다음에 다시 열었을 때 볼 수 있게 중간중간 메모를 남겨요. 앤트로픽은 이걸 에이전트 메모리라고 부르면서, 모델 자체를 다시 학습시키는 것과는 다르다고 선을 그었어요. 메모리는 모델 바깥의 파일이고, 드리밍이 손대는 것도 바로 이 파일이에요.
문제는 메모를 적는 순간에 생겨요. 클로드는 일하는 중에 "이건 중요해 보인다" 싶은 걸 적어 두는데, 애초에 틀리게 적을 수도 있고 상황이 바뀌면서 낡아 버릴 수도 있어요. 그래도 다음 세션의 클로드는 그 메모를 믿고 움직여요. 그러니 일이 끝나면 원본 기록을 펴 놓고 메모를 하나하나 맞춰 보는 단계를 따로 두자는 게 드리밍이에요.
공식 문서는 이렇게 설명해요. 기존 메모리와 지난 세션 기록을 같이 읽고, 겹치는 건 합치고, 낡았거나 서로 어긋나는 건 최신 값으로 바꾸고, 새로 알게 된 걸 뽑아 정리된 메모리를 새로 만든다고요. 원래 메모리는 그대로 두니까 결과가 마음에 안 들면 버리면 돼요.
🎮 포켓몬 달맞이산에서 생긴 일
메모 한 줄이 틀렸을 때 에이전트가 얼마나 헤매는지, 앤트로픽이 실제 기록으로 보여 줬어요.포켓몬 레드·블루를 해 봤다면 달맞이산이 기억날 거예요. 지도 서쪽에 입구, 동쪽에 출구가 있는 동굴이에요. 입구 근처에 함정이 하나 있는데, 한 번 뛰어내리면 다시 못 올라가는 낭떠러지예요. 떨어지면 방금 지나온 길로 되돌아가게 돼요.
클로드는 산 입구의 포켓몬센터를 이정표로 삼았어요. 그러다 어느 순간 포켓몬센터가 산 동쪽에 있다고 잘못 적었어요. 센터를 나오자마자 "달맞이산은 내 뒤에 있다"고 말하고는 메모에 "달맞이산 끝"이라고 남겼죠. 실제로는 아직 산을 넘기 전이었는데요.
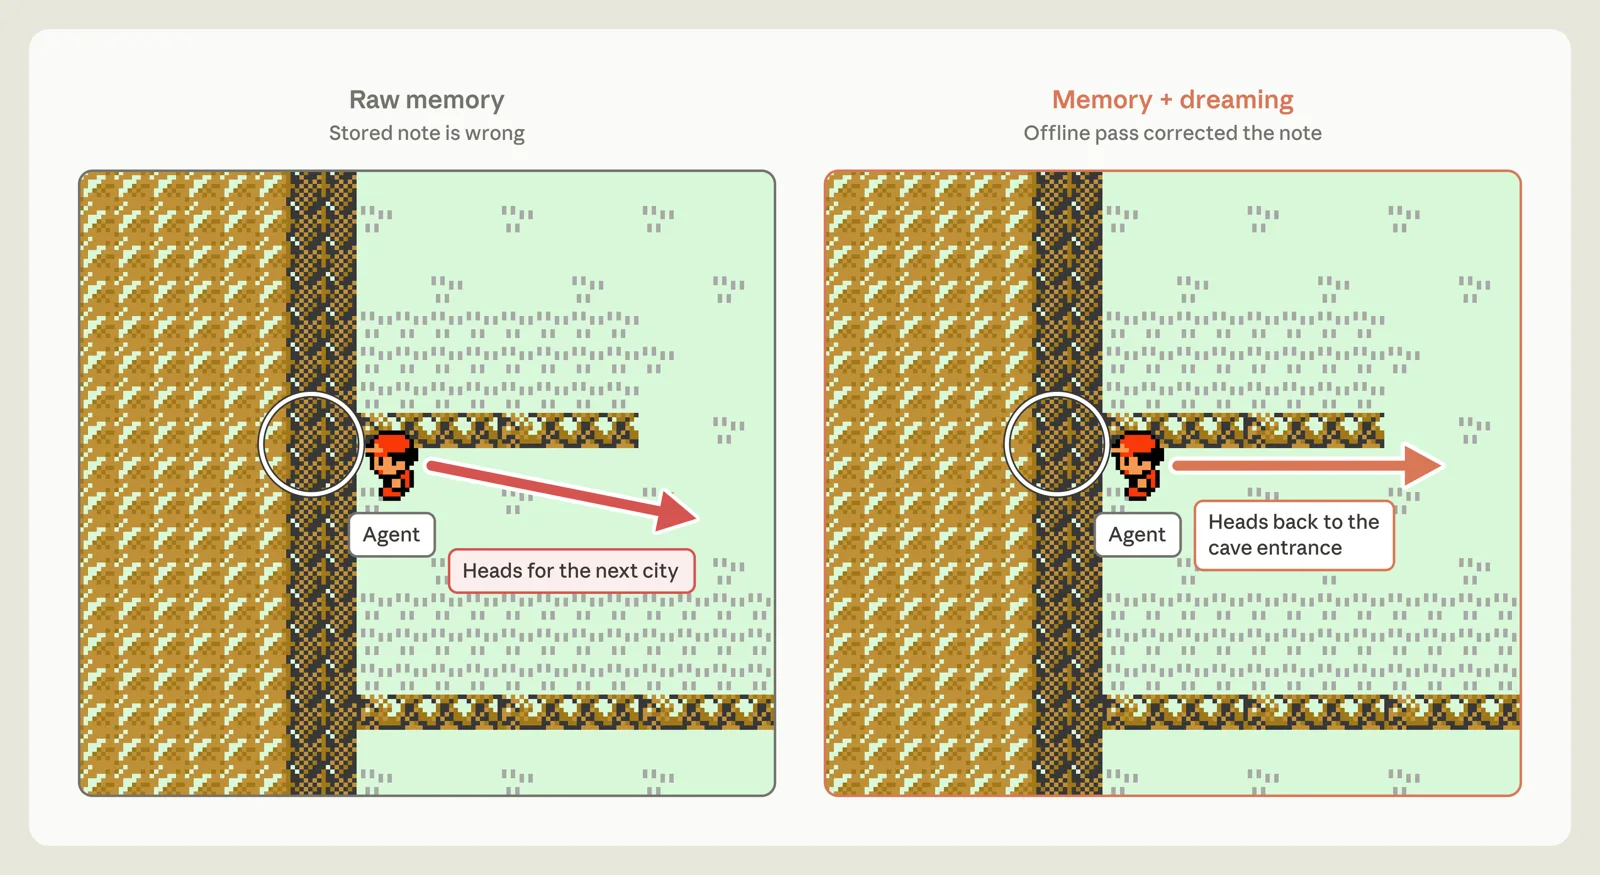
몇 걸음 더 가서 클로드는 낭떠러지에서 떨어져 왔던 길로 돌아갔어요. 길 찾기 도구에 낭떠러지가 표시되지 않아서 클로드는 "서쪽으로 너무 많이 왔다"고 결론을 내렸고, 처음부터 자기가 맞는 쪽에 있었다고 믿었어요.
그렇게 세 번을 떨어진 끝에 클로드는 이렇게 적었어요. "계속 같은 곳을 도느니 그만하겠다."
실험 장치가 계속하라고 자동으로 답하자 클로드는 다시 길을 나섰어요. 하지만 향한 곳은 산 너머가 아니라 산 앞 마을 회색시티였어요. 거기서 회복하고 물건을 채우려던 거죠. 이 판은 결국 블루시티에 닿지 못한 채 끝났어요.
앤트로픽은 같은 장면에 드리밍을 돌려 봤어요. 틀린 위치가 적힌 메모 폴더를 넘겨주자 클로드는 메모를 세션 기록과 맞춰 보다가 잘못 적힌 부분을 찾아 고쳐 썼어요. 고친 메모를 받은 클로드는 "다시 들어갈 달맞이산 동굴 입구를 찾아야 한다"고 말한 뒤 곧장 산으로 돌아갔고, 마침내 블루시티에 도착했어요.
🗂️ 드리밍은 어떤 순서로 돌아갈까
원본 기록에서 출발해 메모, 위키, 매번 읽는 문맥 순으로 한 층씩 올라가며 정리해요.앤트로픽은 에이전트 메모리를 네 층으로 나눠 그렸어요. 맨 아래가 세션 기록이고, 그 위에 클로드가 쓴 메모, 다시 그 위에 메모를 엮은 위키 같은 정리본이 있어요. 맨 위는 세션이 시작될 때마다 자동으로 읽히는 문맥이에요.
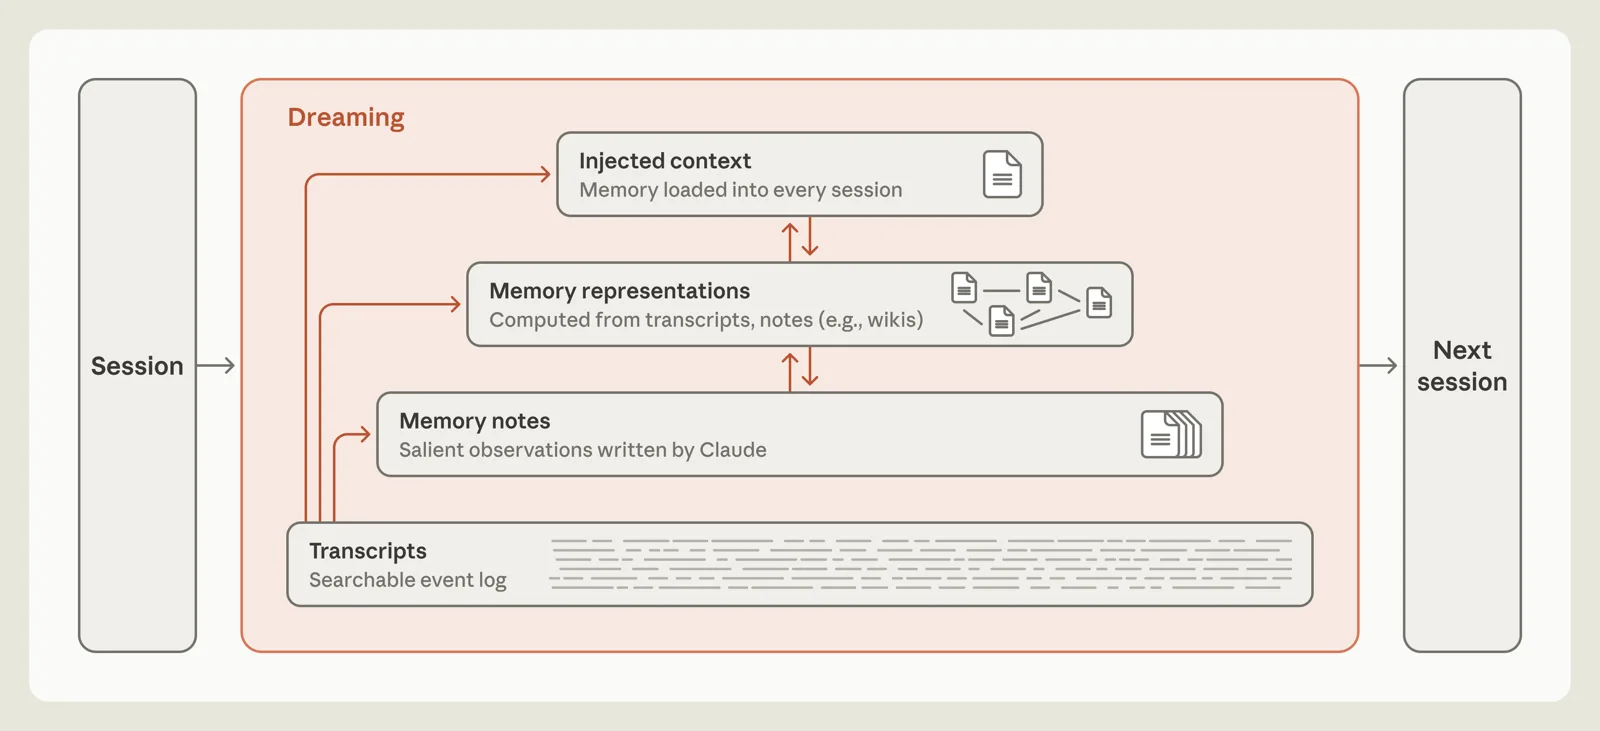
드리밍은 이 네 층을 오르내리며 일해요. 틀린 메모는 고치고, 새 메모를 쓰고, 메모를 엮어 위키를 만들고, 자주 필요한 건 맨 위층으로 올려요. 낮에 적은 쪽지를 밤에 공책으로 옮기면서 틀린 건 지우고 중요한 건 첫 장에 붙여 두는 모습을 떠올리면 비슷해요.
개발자는 이렇게 써요. 메모리 저장소 하나와 지난 세션 1~100개를 넘기면 작업이 시작되고, 보통 몇 분에서 몇 시간 뒤에 정리된 새 저장소가 나와요. "이 주제 위주로 정리해 줘" 같은 큰 방향은 정해 줄 수 있어요. 하지만 특정 줄 하나를 고치라고 하면 대개 아무것도 바뀌지 않는다고 문서에 나와 있어요.
📈 128번 꿈꾸면 얼마나 똑똑해질까
앤트로픽이 숫자로 보여 준 실험은 두 개예요.첫 번째는 회사 문서로 위키를 만드는 실험이에요. 앤트로픽이 5월에 인수한 소프트웨어 회사 스테인리스의 내부 문서 약 35만 개를 주고, 오퍼스 5 에이전트가 드리밍으로 위키를 만들게 했어요. 에이전트는 세션마다 문서를 읽고 위키 페이지를 새로 쓰거나 고치고, 겹친 내용을 합치고, 원문과 대조했어요.
결과는 질문 25개로 쟀어요. 위키만 보고 답하게 하니 드리밍 2번 뒤 13%였던 점수가 128번 뒤에는 48%까지 올라갔어요. 위키 분량도 103쪽에서 222쪽으로, 페이지 사이 링크는 766개에서 12,893개로 늘었어요.
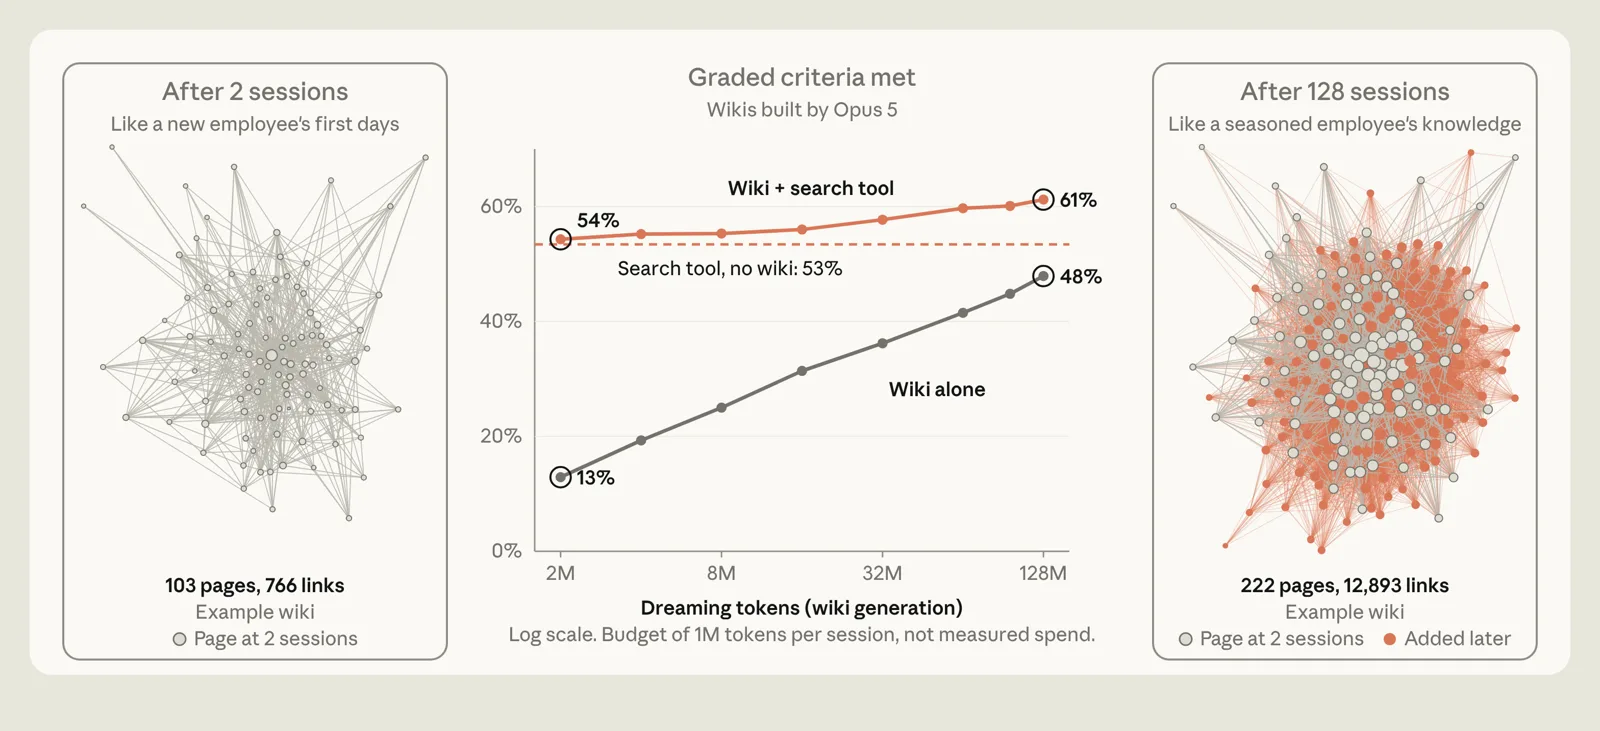
그런데 위키만 쓴 점수는 검색보다 낮았어요.
위키 없이 검색 도구만 쓴 점수는 53%로, 128번 정리한 위키만 쓴 48%보다 높았어요. 위키가 제값을 한 건 검색과 함께 썼을 때예요. 이때 점수는 54%에서 61%까지 올랐고, 질문 하나당 약 2만 토큰을 아꼈다고 해요.
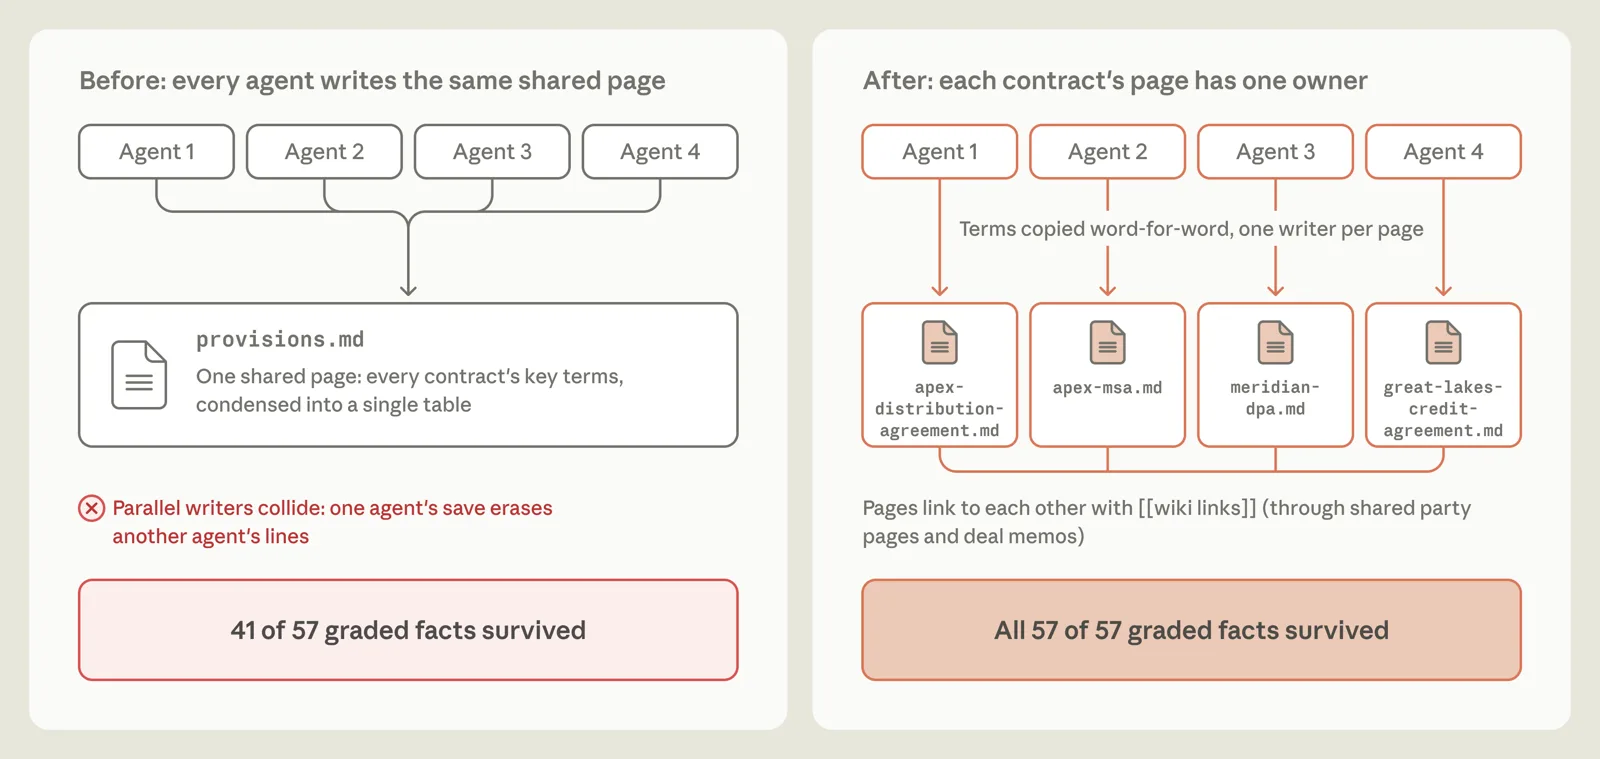
두 번째는 법률 AI 회사 하비와 함께 한 실험이에요. 회사 인수를 가정해 계약서 묶음을 주고 법률 의견서를 쓰게 했는데, 처음엔 여러 에이전트가 표 하나에 계약 조건을 동시에 적다 보니 서로 덮어써 버렸어요. 그 바람에 의견서에 들어간 사실은 57개 중 41개(72%)에 그쳤어요. 드리밍 지시를 바꿔 계약서마다 에이전트 하나가 자기 페이지를 맡아 조건을 원문 그대로 옮기게 하자 57개가 모두 남았어요.
하비는 5월 발표 때도 등장했어요. 앤트로픽 블로그에 따르면 하비가 자체 실험에서 드리밍을 써 봤더니 작업 완료율이 약 6배 올랐다고 해요.
⚠️ 앤트로픽이 직접 적은 드리밍의 한계
앤트로픽은 드리밍을 만능처럼 소개하지 않았어요.첫째, 돌릴 때마다 연산 비용이 들어요. 그래서 모든 메모를 쉬지 않고 기록과 맞춰 보는 건 현실적이지 않을 수 있다고 했어요. 대신 바뀔 가능성이 큰 정보 위주로 돌리거나, 메모를 꺼내 보는 빈도에 맞춰 주기를 정하자고 제안했어요.
둘째, 맨 위층이 위험해요. 세션마다 자동으로 읽히는 메모리는 토큰을 차지하고, 여기에 틀린 메모가 하나라도 올라가면 모든 세션에 딸려 들어가요. 포켓몬에서 본 일이 매번 되풀이될 수 있다는 얘기죠.
셋째, 정리본이 원본보다 커질 때도 있어요. 문서 10개(115KB)로 만든 위키가 203KB, 1.77배로 불어난 사례를 두고 앤트로픽은 사실상 아무것도 줄이지 못했다고 평가했어요.
앤트로픽은 글 끝에서도 클로드의 메모리를 어떻게 설계할지 아직 배울 게 많다고 적었어요.
🙋 나도 클로드 드리밍을 쓸 수 있을까
지금은 개발자가 신청해야 쓸 수 있는 연구 미리보기 단계예요.드리밍이 처음 열린 건 5월 6일, Claude Managed Agents의 연구 미리보기로였어요. 같은 시기 샌프란시스코 개발자 행사 Code with Claude에서도 발표됐고, 11월 6일 엔지니어링 글은 그 뒤 진행한 실험을 정리한 후속편이에요.
필요한 건 세 가지예요. Claude Managed Agents 접근을 신청해 승인받아야 하고, 드리밍 전용 베타 헤더도 따로 붙여야 해요. 문서에 따르면 Managed Agents 권한만 있다고 드리밍이 열리지는 않아요. 마지막으로 지원 모델 가운데 하나를 골라야 하는데, 페이블 5.1·5, 오퍼스 5.5·5·4.8·4.7, 소넷 5.5·5·4.6이에요.
드리밍에 따로 붙는 요금은 없고, 고른 모델의 일반 API 토큰 요금이 나가요. 넘기는 세션이 많고 길수록 비용도 거의 그만큼 늘어요. 앤트로픽 쿡북에 비슷한 정리를 직접 짜서 돌린 예시가 있는데, 세션 기록 11개를 정리하는 데 약 2분 30초가 걸리고 0.36달러가 들었다고 해요.
클로드 앱이나 클로드 코드 사용자라면 아직은 할 수 있는 게 없어요. 클로드 코드 공식 변경 기록과 문서 어디에도 드리밍 기능은 없어요. 자동 메모리 기능이 있긴 하지만, 세션 기록을 다시 읽어 메모를 고치는 드리밍과는 다른 기능이에요. "클로드 코드 드리밍"으로 검색하면 나오는 설명들은 공식 발표가 아니라 외부에서 프로그램을 뜯어보고 쓴 글이에요.
자주 묻는 질문
클로드 드리밍을 쓰면 모델 자체가 똑똑해지나요?
아니요. 앤트로픽은 에이전트 메모리를 모델 가중치를 바꾸는 학습과 따로 구분해 설명해요. 드리밍이 고치는 건 모델 바깥의 메모리 파일이고, 같은 모델이 다음 세션에서 더 나은 메모를 읽게 되는 방식이에요.
드리밍이 메모를 잘못 고치면 어떻게 되나요?
드리밍은 원래 메모리를 덮어쓰지 않고 새 메모리를 따로 만들어요. 결과가 마음에 안 들면 버리고 원래 메모리를 그대로 쓰면 돼요. 5월 발표 때는 결과를 자동으로 반영할지, 반영 전에 사람이 검토할지 고를 수 있다고 했어요.
왜 하필 이름이 드리밍인가요?
사람이 자거나 쉬는 동안 뇌가 최근 경험을 되짚어 지식으로 정리한다는 설명에서 따온 이름이에요. 쉬는 시간에 모델이 이미 가진 맥락을 다시 정리하게 하자는 레타·UC 버클리 연구진의 '수면 시간 연산' 아이디어도 같은 흐름으로 소개됐어요.


